Cloud ou local : où faire tourner votre intelligence artificielle ?
Le nouveau Mac Studio M5 Ultra embarque jusqu'à 512 Go de mémoire unifiée et 1,2 To/s de bande passante : de quoi faire tourner de très grands modèles d'IA sans datacenter. Faut-il rapatrier votre IA en entreprise ? Ce que le matériel permet vraiment, ce que ça coûte, et ce que ça change pour vos données.
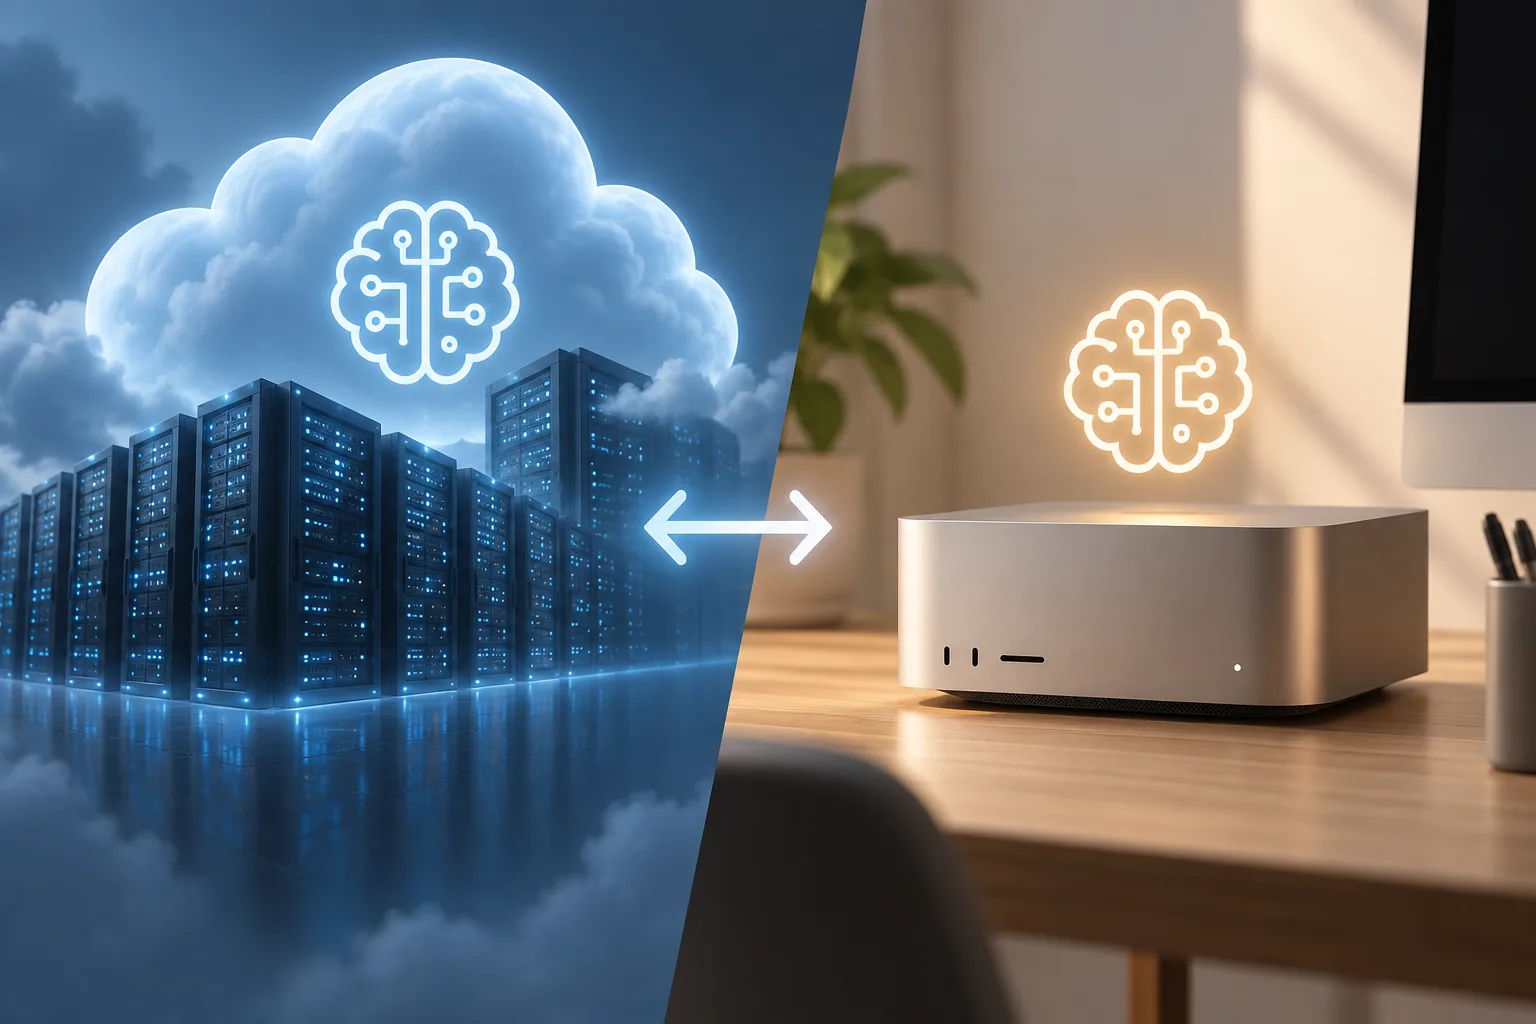
Où faire tourner votre intelligence artificielle : dans le cloud d'un grand fournisseur, ou sur votre propre matériel, dans vos murs ? Il y a deux ans, la question ne se posait pas — seuls les datacenters avaient la puissance nécessaire. En septembre 2026, elle se pose sérieusement. Apple vient de lancer un Mac Studio taillé pour l'IA locale, Nvidia vient de racheter Hugging Face, et les chiffres d'adoption de l'inférence sur site explosent. Voici ce qui a changé, et comment arbitrer.
Le pari d'Apple : l'IA géante sur un coin de bureau
Le 25 août 2026, Apple a ouvert les précommandes de son nouveau Mac Studio, disponible depuis le 22 septembre. La version M5 Ultra propose 96, 256 ou 512 Go de mémoire unifiée, avec une bande passante mémoire de 1,2 To/s — 50 % de plus que la génération précédente. C'est cette bande passante, plus encore que la quantité de mémoire, qui fait la différence : l'inférence d'un grand modèle de langage est limitée par la vitesse à laquelle le processeur lit les poids du modèle, pas par sa puissance de calcul brute.
Concrètement, une machine à quelques milliers d'euros, posée sur un bureau, silencieuse, fait désormais tourner des modèles qui exigeaient un serveur GPU hors de prix il y a dix-huit mois. C'est un pari assumé d'Apple : l'intelligence artificielle n'est plus une affaire exclusive de datacenters.
Apple n'ouvre pas la voie, elle suit une trace déjà creusée par Nvidia. Le DGX Spark, lancé fin 2025 autour de 4 700 dollars, proposait déjà 128 Go de mémoire unifiée et un pétaflop de calcul dans un boîtier de quinze centimètres, capable d'exécuter des modèles jusqu'à 200 milliards de paramètres. Le message des deux constructeurs est le même : le poste de travail redevient une plateforme d'IA à part entière.
Et le 3 septembre 2026, Nvidia a confirmé le rachat de Hugging Face pour 12,9 milliards de dollars. Hugging Face, c'est la plateforme qui distribue les centaines de milliers de modèles ouverts que ces machines font tourner. En l'achetant, Nvidia verrouille toute la chaîne de l'IA locale : le matériel qui exécute les modèles, et la plateforme qui les distribue. Difficile d'envoyer un signal plus clair sur la direction du marché.
La souveraineté des données change de camp
Faire tourner un modèle en local, c'est d'abord une réponse à une question que toutes les entreprises se posent : où vont mes données ? Quand vos équipes envoient des contrats, des dossiers clients ou du code source à une API d'IA américaine, ces données quittent vos murs — avec les questions juridiques (RGPD, secret des affaires, Cloud Act) que cela soulève.
- La part de l'inférence IA exécutée sur site ou en périphérie (edge) est passée de 12 % en 2023 à 55 % en 2026.
- Sur la même période, la part du cloud public pour l'inférence est tombée de 56 % à 41 % en un an.
- Gartner prévoit que plus de 75 % des entreprises européennes et du Moyen-Orient rapatrieront leurs charges de travail d'ici 2030 pour réduire le risque géopolitique.
- Selon Deloitte (State of AI in the Enterprise 2026), la souveraineté de l'IA est devenue un sujet de conseil d'administration, plus seulement de DSI.
Nous le constatons directement : de plus en plus de directions générales font appel aux Entrecodeurs pour arbitrer ces décisions. Le sujet est monté d'un cran — ce n'est plus seulement un choix de DSI, c'est un arbitrage de Codir et de Copil, au même titre qu'un choix d'ERP ou d'hébergement.
Un modèle qui tourne sur votre matériel ne fait sortir aucune donnée. Pas de clause contractuelle à négocier, pas de transfert transatlantique à justifier : le problème disparaît à la racine.
Quelle part du travail peut-on vraiment faire en local ?
Soyons honnêtes : un datacenter sera toujours meilleur. Les modèles frontière — les plus intelligents du marché — ne tiennent pas sur un poste de travail, et ne sont de toute façon pas distribués en poids ouverts. Pour le raisonnement complexe, les agents autonomes longue durée ou les très gros contextes, le cloud garde l'avantage.
Mais la vraie question est ailleurs : quelle part de votre usage quotidien exige réellement un modèle frontière ? Dans les faits, une grande partie des tâches en entreprise est très bien servie par un modèle ouvert local : rédaction et reformulation, résumés de documents, questions-réponses sur votre base documentaire interne (RAG), classification, extraction de données, assistance au code. Ce sont des tâches répétitives, à fort volume — précisément celles qui font gonfler la facture d'API.
- Avec 128 Go de mémoire unifiée : Llama 3.3 70B tourne à 12-18 tokens/seconde — largement fluide pour un usage individuel ou une petite équipe.
- Avec 256 Go et plus : les grands modèles à mélange d'experts (MoE) deviennent accessibles — DeepSeek V3/R1 671B quantisé en 4-bit sort 6 à 18 tokens/seconde, Qwen3-235B entre 16 et 24 tokens/seconde selon le framework.
- Les modèles MoE n'activent qu'une fraction de leurs paramètres à chaque token : c'est exactement ce qui permet à une machine limitée par la bande passante de servir des modèles dont la taille brute semble hors de portée.
Réduire la facture et la dépendance
L'argument économique est devenu difficile à ignorer. À volume égal, un modèle ouvert auto-hébergé coûte jusqu'à 18 fois moins cher par million de tokens qu'une API premium. Les retours d'expérience documentés vont dans le même sens : une fintech a réduit sa dépense IA mensuelle de 47 000 à 8 000 dollars (-83 %) en passant en auto-hébergement hybride ; un autre cas rapporte plus de 140 000 dollars d'économies annuelles avec, au passage, 100 % de maîtrise des données.
L'enjeu dépasse la facture : c'est la dépendance. Quand toute votre chaîne de valeur repose sur l'API d'un fournisseur unique, vous subissez ses hausses de prix, ses changements de modèles, ses pannes et ses conditions d'utilisation. Un socle local — même partiel, même en complément du cloud — redonne une marge de négociation et un plan B.
L'approche raisonnable en 2026 n'est pas le tout-local, c'est l'hybride : le local pour les tâches à fort volume et les données sensibles, le cloud pour les cas qui exigent un modèle frontière. C'est l'arbitrage que nous construisons avec nos clients.
Les logiciels deviennent des harnais pour modèles
Il y a une lecture plus profonde de ce mouvement : le logiciel d'entreprise est en train de changer de nature. Une application métier moderne n'est plus seulement un ensemble d'écrans et de règles — c'est un harnais qui orchestre des modèles d'IA : il leur fournit le contexte, encadre leurs réponses, vérifie leurs sorties et les connecte à vos données. Le modèle devient un composant d'infrastructure, comme la base de données l'est depuis quarante ans. Et comme pour la base de données, la question « hébergée où ? » redevient un choix d'architecture, pas une fatalité.
Chez Les Entrecodeurs, nous en avons pleinement conscience : c'est déjà ainsi que nous concevons nos solutions d'intelligence artificielle. Pour les entreprises, cela signifie une double montée en compétence : savoir installer et opérer les logiciels (les harnais), mais aussi dimensionner et administrer le matériel qui fait tourner les modèles. C'est un métier — proche de l'infogérance, avec des enjeux de sécurité spécifiques — et il s'apprend maintenant, pendant que le mouvement est encore jeune.
À propos de l'auteur
Flavien Bigi
Gérant des Entrecodeurs, chef de projet IT
Chef de projet IT depuis 2016, Flavien Bigi dirige Les Entrecodeurs. Il intervient sur les projets d'intelligence artificielle en entreprise — audits de système d'information, accès aux données, architectures de recherche augmentée et encadrement des agents — et accompagne les dirigeants de PME et d'ETI dans leurs arbitrages techniques.
Questions fréquentes
- Comment Les Entrecodeurs aident-ils à choisir entre IA cloud et IA locale ?
- Les Entrecodeurs commencent par cartographier les usages IA réels de l'entreprise : volumes, sensibilité des données, exigence de qualité par tâche. Nous en déduisons une architecture hybride — modèles locaux pour le volume et le sensible, cloud pour les cas frontière — puis nous chiffrons le matériel et accompagnons le déploiement via notre service d'intégration IA.
- Quel matériel faut-il pour faire tourner un modèle d'IA en entreprise ?
- Une machine avec 24 à 32 Go de mémoire suffit pour un modèle comme Qwen3.8-27B, très capable au quotidien. Pour des modèles de 70 milliards de paramètres, comptez 128 Go de mémoire unifiée ; au-delà (DeepSeek, Qwen3-235B), il faut 256 Go et plus, comme sur le Mac Studio M5 Ultra ou le Nvidia DGX Spark. Les Entrecodeurs dimensionnent ce matériel selon vos usages réels.
- Un modèle d'IA local est-il vraiment sûr pour les données de l'entreprise ?
- Oui, c'est même son principal atout : les données ne quittent jamais l'infrastructure de l'entreprise, ce qui neutralise les questions de transfert hors UE et de Cloud Act. La sécurité se joue alors sur votre propre réseau — accès, chiffrement, mises à jour — comme pour tout serveur interne. Les Entrecodeurs intègrent cette dimension dans leur offre de cybersécurité.
- L'IA locale peut-elle remplacer complètement ChatGPT ou Claude en entreprise ?
- Pas entièrement : les modèles frontière du cloud restent supérieurs pour le raisonnement complexe et les agents autonomes. En revanche, une grande partie des tâches quotidiennes — résumés, rédaction, RAG interne, classification, assistance au code — est très bien servie par un modèle ouvert local, pour une fraction du coût. L'approche recommandée par Les Entrecodeurs est hybride.
- Combien coûte le passage à une IA auto-hébergée ?
- L'investissement se limite au matériel (de 2 000 € pour un poste à 10 000-15 000 € pour une machine de type Mac Studio M5 Ultra ou DGX Spark) et à l'intégration. À fort volume, le retour est rapide : les modèles ouverts auto-hébergés coûtent jusqu'à 18 fois moins cher par million de tokens, avec des cas documentés de 65 à 83 % d'économies sur la facture IA mensuelle.
Sources
- MacGeneration — Apple présente un nouveau Mac Studio M5 Max / M5 Ultra
- Lokan — Mac Studio M5 Ultra : prix, performances et 512 Go de RAM
- TechCrunch — Nvidia confirms it will buy Hugging Face for $12.9 billion
- CNN Business — Nvidia inks $13 billion deal to buy Hugging Face
- Nvidia — DGX Spark, Personal AI Supercomputer
- DreamFactory — 28 On-Premise LLM Deployment Statistics (2026)
- Accrets — The Executive Playbook to On-Premise LLM Deployment in 2026
- jamesm.blog — Which Mac Studio Should You Buy for Running LLMs Locally?
- Hardwarepedia — Best Mac for Running AI Locally in 2026
- BenchLM.ai — Qwen3.8-27B Benchmarks & Speed
- Kingy.ai — Qwen3.8-27B : specs, benchmarks & verdict
- OrcaRouter — Qwen3.8-27B Benchmarks
- Yotta Labs — Qwen 3.8 27B : specs et configuration requise
À lire ensuite
Odoo 20 : ce qui nous attend
Odoo 20 a été dévoilé lors de la keynote d'ouverture d'Odoo Experience, le 24 septembre 2026 à Bruxelles. IA embarquée dans les processus, serveur MCP natif, nouveaux métiers, refonte mobile : ce que l'on savait avant l'annonce, et ce que cela implique pour votre calendrier de migration.
Facturation électroniquePourquoi e.Invoicing Hub
Nous éditons des produits qui émettent des factures, et nous maintenons des dizaines de logiciels métier développés ou repris chez nos clients. Chacun de ces clients arrive avec sa propre Plateforme Agréée — très souvent Pennylane, parce que c'est celle de son cabinet comptable. Multiplier les intégrations n'était pas tenable : voilà comment est né e.Invoicing Hub.