Intelligence artificielle

Choisir et dimensionner vos modèles IA

Quel modèle pour quelle tâche, exécuté où, sur quelle machine et pour combien d'utilisateurs simultanés : ce sont les quatre questions qui décident du coût d'un projet IA et de sa viabilité dans la durée. Les Entrecodeurs y répondent avant le développement, chiffres à l'appui, sur la base de ce qu'ils exploitent eux-mêmes.

Familles de modèles

Cinq familles, cinq coûts très différents.

Parler d'« IA » au singulier conduit à payer un modèle de langage pour une tâche qu'un modèle de classification réglerait en millisecondes. Ranger chaque tâche dans la bonne famille est le premier travail d'un projet — et souvent là que se joue l'essentiel de l'économie.

Décision

Classification, scoring, priorisation, détection d'anomalie.

4 à 8 Go, serveur CPU, réponse en millisecondes

Vision

Lecture de documents, reconnaissance de plans, contrôle qualité par image.

8 à 16 Go, carte graphique utile en traitement par lots

Transcription

Réunions, appels, conférences, support téléphonique.

10 à 16 Go de VRAM, un flux temps réel par carte graphique

Langage

Rédaction, synthèse, raisonnement, appel d'outils par un agent.

6 à 50 Go selon la taille du modèle, la famille la plus coûteuse

Représentation vectorielle

Recherche sémantique dans vos documents, socle de tout système RAG.

1 à 4 Go, serveur CPU, indexation à réactualiser régulièrement

Parler d'« IA » au singulier conduit à payer un modèle de langage pour une tâche qu'un modèle de classification réglerait en millisecondes. Les Entrecodeurs distinguent cinq familles aux coûts et aux exigences matérielles très différents : décision, vision, transcription, langage et représentation vectorielle. Le premier travail d'un projet consiste à ranger chaque tâche dans la bonne famille — c'est souvent là que se joue l'essentiel de l'économie.

  • Modèles de décision : classification, scoring, détection d'anomalie — quelques Go de mémoire, pas de carte graphique, réponse en millisecondes
  • Modèles de vision : lecture de documents, reconnaissance de plans, contrôle qualité par image
  • Modèles de transcription : Whisper pour les réunions, appels et conférences
  • Modèles de langage : rédaction, synthèse, raisonnement, appel d'outils — les plus coûteux
  • Modèles de représentation vectorielle : recherche sémantique dans vos documents, socle de tout système RAG

Les Entrecodeurs tranchent tâche par tâche sur quatre critères : confidentialité de la donnée, volume traité, latence attendue et coût réel au millier de traitements. Un volume élevé sur des données sensibles justifie presque toujours l'internalisation. Un volume faible sur une tâche de raisonnement justifie presque toujours l'API. La plupart des projets finissent en architecture mixte, et c'est un bon signe : cela veut dire que l'arbitrage a vraiment eu lieu.

  • Confidentialité : une donnée qui ne doit pas sortir décide seule, les autres critères viennent ensuite
  • Volume : au-delà d'un certain nombre de traitements par mois, l'infrastructure locale coûte moins qu'un abonnement à l'usage
  • Latence : un modèle local répond sans aller-retour réseau, ce qui compte pour un usage interactif
  • Coût au millier de traitements, pas coût par appel : c'est la seule unité qui permet de comparer

Les Entrecodeurs appliquent une règle simple : la mémoire nécessaire vaut le poids du modèle quantifié plus environ 2 Go par conversation simultanée. Un modèle de 70 milliards de paramètres occupe 40 à 50 Go et sert une cinquantaine d'utilisateurs sur une machine à mémoire unifiée de 128 Go comme une DGX Spark. Un modèle de 7 à 8 milliards tient sur un Framework Desktop et suffit à une vingtaine d'utilisateurs. Un modèle de décision tourne sur un serveur sans carte graphique.

  • Modèle de décision : 4 à 8 Go, serveur CPU, 200 utilisateurs et plus
  • Transcription Whisper large : 10 à 16 Go de VRAM, un flux temps réel par carte graphique
  • Modèle de langage 7 à 8 milliards quantifié : 6 à 10 Go, Framework Desktop, 10 à 20 utilisateurs
  • Modèle de langage 70 milliards quantifié : 40 à 50 Go, DGX Spark à mémoire unifiée, 50 à 100 utilisateurs
  • Déploiement dans notre infrastructure, sur instance GPU européenne, ou sur une machine chez vous

Le mot est utilisé à tort et à travers, alors Les Entrecodeurs précisent ce qu'ils revendiquent. Trois engagements tenables : vos données ne sortent pas de chez vous quand le déploiement est local, l'hébergement reste en France ou en Europe quand il est managé, et les modèles utilisés ont des poids ouverts et téléchargeables. En revanche, nous ne promettons pas que le modèle soit toujours édité en Europe : le meilleur modèle pour une tâche donnée ne l'est pas toujours, et le prétendre serait malhonnête.

  • Vos données ne sortent pas de chez vous : traitement sur une machine dédiée dans vos locaux, sans appel externe
  • Hébergement en France ou en Europe : OVH, Scaleway ou notre infrastructure, conformité RGPD native
  • Modèles à poids ouverts : Qwen, Mistral, Whisper — aucun fournisseur ne peut couper l'accès ni changer le prix
  • Ce que nous ne promettons pas : un éditeur systématiquement européen, parce que le meilleur modèle d'une tâche ne l'est pas toujours
Les Entrecodeurs conçoivent chaque système pour que le modèle soit remplaçable. Les appels passent par une couche d'abstraction, les prompts et les jeux d'évaluation sont versionnés dans votre dépôt, et la qualité est mesurée par des tests reproductibles plutôt que par impression. Changer de modèle devient alors une décision technique de quelques jours, pas une refonte. C'est la garantie la plus concrète de réversibilité, bien avant le choix du drapeau du fournisseur.

  • Couche d'abstraction entre votre application et le modèle, pour pouvoir en changer sans réécrire
  • Prompts, paramètres et jeux d'évaluation versionnés dans votre dépôt Git
  • Tests de qualité reproductibles : on mesure une régression au lieu de la constater
  • Modèles à poids ouverts conservés localement, utilisables même si le projet amont s'arrête

Les Entrecodeurs chiffrent le coût d'exploitation pendant la preuve de concept, sur vos données réelles et votre volume réel. Pour une architecture locale, il s'agit d'un coût d'infrastructure essentiellement fixe. Pour une architecture frontier, il croît avec le volume. L'intérêt d'une architecture mixte est précisément de rendre la part variable proportionnelle au taux d'échec plutôt qu'au volume total, ce qui change complètement la trajectoire de coût à trois ans.

  • Mesure du coût réel pendant la preuve de concept, pas estimation au doigt mouillé
  • Infrastructure locale : coût fixe, prévisible, amortissable
  • Modèle frontier : coût variable, proportionnel au volume traité
  • Architecture mixte : la part variable ne porte que sur le reliquat, pas sur l'ensemble du flux

Ce qu'on développe

  • 01

    Audit d'arbitrage

    Analyse de chaque tâche de votre projet, classement dans la bonne famille de modèles et arbitrage local ou frontier selon la confidentialité, le volume, la latence et le coût au millier de traitements.

  • 02

    Dimensionnement matériel

    Calcul de la mémoire, du processeur, de la carte graphique et du stockage nécessaires pour vos modèles et votre nombre d'utilisateurs simultanés, avec le coût d'exploitation associé, avant le développement.

  • 03

    Déploiement local

    Installation et exploitation de modèles à poids ouverts sur DGX Spark, sur Framework Desktop ou sur une machine dédiée chez vous, avec vLLM ou Ollama selon le profil de charge.

  • 04

    Infrastructure cloud européenne

    Déploiement sur instances GPU OVH ou Scaleway quand il faut de l'élasticité, avec hébergement en France ou en Europe et conformité RGPD native.

  • 05

    Spécialisation sur vos données

    Adaptation d'un modèle existant à votre métier par RAG, par LoRA ou par fine-tuning, selon le volume de données disponible et la précision attendue. Souvent quelques centaines d'exemples suffisent.

  • 06

    Évaluation et réversibilité

    Mise en place de jeux d'évaluation reproductibles et d'une couche d'abstraction pour que changer de modèle reste une décision de quelques jours plutôt qu'une refonte.

Local ou frontier

Ce qui s'internalise, et ce qui ne s'internalise pas.

Les Entrecodeurs font tourner des modèles locaux sur DGX Spark et sur Framework Desktop, et utilisent les modèles frontier quand ils sont objectivement meilleurs. Le choix ne se fait pas par principe mais tâche par tâche, sur quatre critères : confidentialité de la donnée, volume traité, latence attendue et coût réel au millier de traitements. Voici notre grille, telle que nous l'appliquons en interne.

OCR de factures, bons de commande, contrats

Local

Volume élevé, format répétitif, données comptables sensibles. Un modèle local calibré sur vos formats dépasse un modèle généraliste et ne facture pas à la page.

Transcription de réunions et d'appels (STT)

Local

Whisper tourne très bien sur une machine dédiée. Les conversations internes n'ont aucune raison de sortir de l'entreprise.

Classification, scoring, détection d'anomalie

Local

Des modèles compacts suffisent et répondent en millisecondes. Un LLM frontier serait plus lent, plus cher et moins reproductible.

Extraction sur documents hétérogènes et mal structurés

Mixte

Le modèle local traite les cas standards, le modèle frontier reprend les 5 à 10 % de documents qui échouent. Le coût suit le taux d'échec, pas le volume.

Rédaction longue, synthèse, raisonnement complexe

Frontier

L'écart de qualité reste net et le volume est faible. Internaliser ici coûterait plus cher que l'API pour un résultat inférieur.

Agents qui orchestrent plusieurs outils métier

Frontier

La fiabilité de l'appel d'outils et le respect des formats restent l'avantage décisif des modèles frontier. Les étapes déterministes de l'agent, elles, repassent en local.

Dimensionnement

Quelle machine pour combien d'utilisateurs ?

Les Entrecodeurs dimensionnent l'infrastructure avant d'écrire la première ligne de code : mémoire, processeur, carte graphique, stockage. Les chiffres ci-dessous sont ceux que nous appliquons sur nos propres déploiements, sur DGX Spark, sur Framework Desktop et sur instances GPU OVH ou Scaleway. La machine peut vivre dans notre cloud ou dans vos locaux — le calcul est le même.

UsageMémoire modèleMachineUtilisateurs servisStockage
Modèle de décision (classification, scoring, anomalie)4 à 8 GoServeur CPU, sans GPU200 et plus20 Go
OCR documentaire (factures, contrats, formulaires)8 à 16 GoServeur CPU, GPU utile en traitement par lots50 en flux continu100 Go et plus selon l'archivage
Transcription Whisper large (STT)10 à 16 Go de VRAMFramework Desktop ou instance GPU cloud1 flux temps réel par GPU, 10 à 20 heures d'audio par nuit en lots50 Go hors conservation des fichiers audio
LLM local 7 à 8 milliards de paramètres (quantifié)6 à 10 GoFramework Desktop 128 Go10 à 20 en simultané50 Go
LLM local 30 à 32 milliards de paramètres (quantifié)20 à 28 GoFramework Desktop 128 Go ou DGX Spark20 à 50 en simultané100 Go
LLM local 70 milliards de paramètres (quantifié)40 à 50 GoDGX Spark 128 Go de mémoire unifiée50 à 100 en simultané200 Go

Règle de dimensionnement : mémoire nécessaire = poids du modèle + environ 2 Go par conversation simultanée pour le contexte. Un modèle qui occupe 40 Go et sert 20 utilisateurs en même temps demande donc 80 Go de mémoire, pas 40.

Souveraineté

Ce que « souverain » veut dire ici.

Le mot est utilisé à tort et à travers. Les Entrecodeurs s'engagent sur trois points précis et vérifiables — et disent aussi ce qu'ils ne promettent pas.

Vos données ne sortent pas de chez vous

Traitement sur une machine dédiée dans vos locaux, sans appel à un service externe pour le fonctionnement courant. C'est l'engagement le plus fort et celui que nous tenons sur tout déploiement local.

Hébergement en France ou en Europe

Quand le service est managé, il tourne sur OVH, Scaleway ou notre propre infrastructure. Aucun transfert hors Union européenne, conformité RGPD native.

Modèles à poids ouverts

Qwen, Mistral, Whisper : les poids sont téléchargeables et conservés localement. Aucun fournisseur ne peut couper l'accès, changer ses conditions ou retirer une version du jour au lendemain.

Ce que nous ne promettons pas : un modèle systématiquement édité en Europe. Le meilleur modèle pour une tâche donnée ne l'est pas toujours, et l'affirmer reviendrait à vous vendre un drapeau plutôt qu'un résultat. Quand un modèle non européen est le bon choix, nous le disons et nous l'exécutons sur une machine que vous contrôlez.

Nos technologies

Les outils et frameworks que nous maîtrisons pour ce service.

Nos réalisations

Projet Minitux — Souveraineté et infrastructure IA locale

Intelligence artificielle

Minitux — Souveraineté et infrastructure IA locale

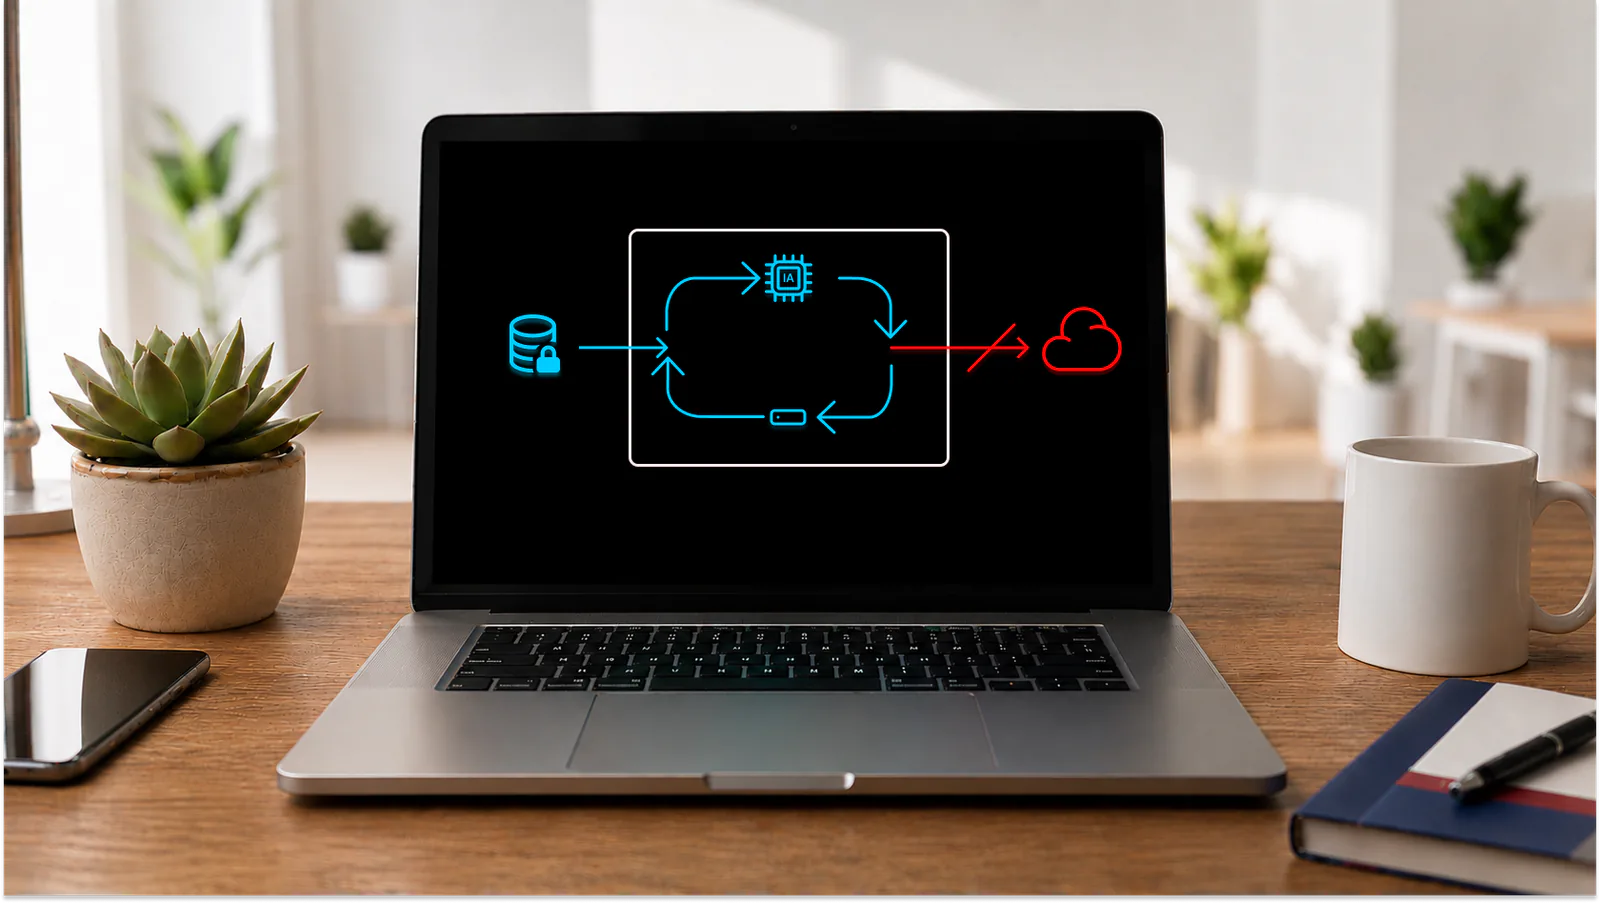
Mise en place d'une infrastructure hybride composée d'un serveur haute performance (Minitux) et de nœuds de calcul locaux pour l'exécution simultanée d'agents IA autonomes en circuit fermé.

  • Linux
  • Debian
  • Scripts bash
  • Docker
Projet Time MCP — Automatisation du suivi d'activité via Chatbot

Intelligence artificielle

Time MCP — Automatisation du suivi d'activité via Chatbot

Évolution de l'infrastructure de gestion de temps des Entrecodeurs par l'intégration d'un agent intelligent à l'écosystème SolidTime. Ce projet permet de piloter le suivi des tâches et du temps de production via une interface textuelle simplifiée, supprimant toute saisie manuelle dans l'interface graphique.

  • React
  • TypeScript
  • SQL
  • Gemma

FAQ

Questions fréquentes

Combien de RAM faut-il pour faire tourner un LLM en local ?

Les Entrecodeurs appliquent la règle suivante : mémoire nécessaire = poids du modèle quantifié + environ 2 Go par conversation simultanée. Un modèle de 7 à 8 milliards de paramètres demande 6 à 10 Go, un modèle de 30 à 32 milliards 20 à 28 Go, un modèle de 70 milliards 40 à 50 Go. Un modèle de 40 Go servant 20 utilisateurs simultanés réclame donc environ 80 Go de mémoire, pas 40.

Vaut-il mieux une IA locale ou une API comme Claude ou GPT ?

Les Entrecodeurs tranchent tâche par tâche. L'OCR, la transcription, la classification et le scoring s'internalisent presque toujours : volume élevé, données sensibles, coût prévisible. La rédaction longue, le raisonnement complexe et l'orchestration d'outils restent en modèle frontier, où l'écart de qualité justifie l'usage facturé. La plupart des projets finissent en architecture mixte, et c'est le signe que l'arbitrage a réellement eu lieu.

Qu'est-ce qu'une IA souveraine, concrètement ?

Chez Les Entrecodeurs, le mot recouvre trois engagements précis : vos données ne sortent pas de chez vous quand le déploiement est local, l'hébergement reste en France ou en Europe quand il est managé, et les modèles utilisés ont des poids ouverts et téléchargeables. Nous ne promettons pas que le modèle soit toujours édité en Europe, parce que le meilleur modèle pour une tâche donnée ne l'est pas toujours.

Faut-il acheter une machine ou louer une instance GPU ?

Les Entrecodeurs comparent les deux sur votre profil de charge. Une charge régulière et prévisible amortit vite une machine dédiée — DGX Spark ou Framework Desktop selon la taille du modèle — et le coût devient fixe. Une charge irrégulière ou saisonnière se traite mieux sur instance GPU OVH ou Scaleway, où l'on ne paie que les heures utilisées. Un déploiement local reste indispensable dès que les données ne doivent pas sortir.

Faut-il beaucoup de données pour spécialiser un modèle ?

Pas nécessairement. Les Entrecodeurs utilisent le RAG et le LoRA, qui adaptent un modèle existant avec très peu de données. Le prompt engineering ne demande aucune donnée d'entraînement et le fine-tuning fonctionne à partir de quelques centaines d'exemples. L'enjeu réel est bien plus souvent la qualité des données et les droits d'accès que leur volume.

Que se passe-t-il si le modèle choisi devient obsolète ?

Les Entrecodeurs conçoivent chaque système pour que le modèle soit remplaçable : couche d'abstraction entre l'application et le modèle, prompts et jeux d'évaluation versionnés dans votre dépôt, tests de qualité reproductibles. Changer de modèle devient une décision technique de quelques jours. Les modèles à poids ouverts conservés localement continuent par ailleurs de fonctionner même si le projet amont s'arrête.

On en parle ?

Dimensionnons votre projet IA.

Sans engagement · Réponse sous 48hVoir nos réalisations