Intelligence artificielle

OCR as a service : vos documents lus, vérifiés et intégrés

Lire un document ne suffit pas : il faut vérifier ce qui a été lu, décider quoi faire des cas douteux et déposer le résultat au bon endroit. Les Entrecodeurs déploient des services d'extraction documentaire calibrés sur vos formats réels, dimensionnés pour votre volume, hébergés sur nos serveurs ou sur une machine dédiée dans vos locaux.

La chaîne complète

De la page scannée à la pièce dans votre ERP.

Un OCR qui s'arrête à la lecture laisse le travail à vos équipes. Les cinq étapes ci-dessous sont celles que Les Entrecodeurs livrent systématiquement — la quatrième étant celle qui distingue un service exploitable d'une démonstration réussie.

  1. Étape 1

    Lecture

    Le document est lu quelle que soit sa qualité : scan, photo, PDF natif, document réimprimé puis renumérisé.

  2. Étape 2

    Structuration

    Les champs métier sont extraits et typés — fournisseur, montants, dates, références — au lieu d'un bloc de texte à retraiter.

  3. Étape 3

    Contrôle

    Les données sont confrontées à votre référentiel : le fournisseur existe-t-il, le montant correspond-il à la commande, les mentions obligatoires sont-elles présentes.

  4. Étape 4

    Reprise des échecs

    Les documents que le modèle local n'a pas su lire passent à un modèle frontier, puis en validation humaine ciblée sur le champ incertain. Rien ne disparaît en silence.

  5. Étape 5

    Dépôt

    La pièce est créée dans Odoo, Sage ou votre ERP, classée dans la GED avec ses métadonnées, ou exposée via API à vos applications.

Une offre OCR packagée arrive

Les Entrecodeurs préparent une offre OCR as a service avec API et tarification à l'usage. En attendant son ouverture, le service est déployé projet par projet : nous analysons vos documents réels, calibrons le modèle sur vos formats et installons le service sur nos serveurs ou sur une machine dédiée dans vos locaux.

Un OCR qui se contente de transformer une image en texte ne règle rien : vos équipes doivent encore relire, corriger et ressaisir. Les Entrecodeurs livrent la chaîne entière — lecture, structuration des champs, confrontation à votre référentiel, traitement des cas douteux et dépôt dans votre système. La valeur ne vient pas du taux de reconnaissance brut mais de ce qui arrive aux documents que la machine lit mal.

  • Lecture du document, quelle que soit sa qualité : scan, photo, PDF natif, fax reconverti
  • Structuration en champs métier utilisables, pas en bloc de texte à retraiter
  • Confrontation au référentiel : le fournisseur existe-t-il, le montant correspond-il à la commande
  • Dépôt direct dans l'ERP, la GED ou la base de données, sans étape de ressaisie

C'est la question que la plupart des offres OCR évitent. Les Entrecodeurs traitent les documents en échec en deux temps : un modèle frontier reprend les cas que le modèle local n'a pas su lire, ce qui absorbe l'essentiel du reliquat, et ce qui reste part en file de validation humaine avec le champ problématique mis en évidence. Le coût suit donc le taux d'échec et non le volume total, et aucun document ne disparaît silencieusement.

  • Premier passage en modèle local calibré sur vos formats, sur l'essentiel du volume
  • Reprise automatique des cas en échec par un modèle frontier, facturé à l'usage sur ce reliquat seulement
  • File de validation humaine pour le solde, avec le champ incertain signalé plutôt que le document entier à relire
  • Chaque correction humaine est conservée et sert à calibrer le modèle sur vos documents

Les Entrecodeurs calibrent leurs services OCR sur les documents de gestion courante — factures fournisseurs, bons de commande, bons de livraison, contrats, formulaires, relevés — ainsi que sur des documents techniques plus difficiles comme les plans 2D. Un modèle généraliste traite mal un formulaire propre à votre métier ; c'est la calibration sur vos formats réels, et non le choix du modèle, qui fait la précision.

  • Documents comptables : factures, avoirs, bons de commande, bons de livraison, relevés bancaires
  • Documents contractuels : contrats, avenants, conditions particulières, attestations
  • Formulaires métier propres à votre activité, y compris manuscrits partiellement remplis
  • Plans techniques 2D convertis en fichiers vectoriels modifiables (DXF, SVG)

Les Entrecodeurs déploient le service là où vos contraintes l'exigent : sur leurs serveurs, sur une instance GPU européenne, ou sur une machine dédiée installée dans vos locaux. Pour un service on-premise, nous dimensionnons la machine en fonction de votre volume quotidien et de votre exigence de délai. Les documents comptables et contractuels justifient souvent que rien ne sorte de l'entreprise : c'est un choix que nous respectons sans le facturer comme une option exotique.

  • Sur nos serveurs, en service managé, avec engagement de délai de traitement
  • Sur une machine dédiée dans vos locaux, dimensionnée pour votre volume quotidien
  • Sur instance GPU européenne (OVH, Scaleway) quand il faut de l'élasticité
  • Dans tous les cas, modèles à poids ouverts : aucun fournisseur ne peut couper le service ou changer son prix du jour au lendemain

Les Entrecodeurs partent du volume quotidien de documents et du délai attendu. L'extraction documentaire tourne très bien sur un serveur sans carte graphique, avec 8 à 16 Go de mémoire, pour un flux continu correspondant à une cinquantaine d'utilisateurs. La carte graphique ne devient utile qu'en traitement par lots importants, typiquement une reprise d'archives ou une fin de mois comptable. Le dimensionnement est annoncé avant le développement, pas découvert en production.

  • Flux continu, une cinquantaine d'utilisateurs : serveur CPU, 8 à 16 Go de mémoire, pas de GPU nécessaire
  • Traitement par lots ou reprise d'archives : une carte graphique divise le temps de traitement
  • Stockage à prévoir selon la durée de conservation des documents sources, pas seulement des données extraites
  • Le coût d'exploitation est chiffré sur votre volume réel avant la première ligne de code

Les Entrecodeurs intègrent la sortie du service OCR directement dans l'outil où vos équipes travaillent déjà : création de la facture fournisseur dans Odoo ou Sage, dépôt du document classé dans la GED, alimentation d'une base métier. Un OCR qui produit un fichier à réimporter à la main n'a économisé que la frappe. L'intégration se fait par API, par connecteur MCP ou par un développement sur mesure quand l'outil est ancien.

  • Création directe des pièces dans Odoo, Sage ou votre ERP métier
  • Classement automatique dans la GED avec les métadonnées extraites
  • Rapprochement avec la commande ou le contrat d'origine, et signalement des écarts
  • API REST pour brancher le service sur vos propres applications

Ce qu'on développe

  • 01

    Service OCR sur mesure

    Analyse de vos documents réels, calibration du modèle sur vos formats, définition des champs à extraire et des règles de contrôle. Livré intégré dans votre système, pas sous forme de fichiers à retraiter.

  • 02

    Déploiement on-premise

    Installation du service sur une machine dédiée dans vos locaux, dimensionnée pour votre volume quotidien. Aucun document ne sort de l'entreprise, aucune dépendance à un fournisseur externe pour le fonctionnement courant.

  • 03

    Reprise d'archives

    Numérisation et extraction en masse de fonds documentaires existants, en traitement par lots sur machine équipée d'une carte graphique. Le volume est traité une fois, le service courant tourne ensuite sur une machine plus modeste.

  • 04

    Contrôle et rapprochement

    Confrontation automatique des données extraites à votre référentiel : existence du fournisseur, cohérence avec la commande, conformité des mentions obligatoires. Les écarts sont signalés avec leur motif, pas rejetés en bloc.

  • 05

    Reconnaissance de plans 2D

    Détection des murs, ouvertures, cotes et annotations sur des plans papier ou PDF, et conversion en fichiers vectoriels modifiables. Un cas d'usage que les offres OCR généralistes ne traitent pas.

  • 06

    Intégration ERP et GED

    Création des pièces directement dans Odoo, Sage ou votre outil métier, classement dans la GED avec les métadonnées extraites, et API REST pour vos propres applications.

Dimensionnement

Quelle machine pour combien d'utilisateurs ?

Les Entrecodeurs dimensionnent l'infrastructure avant d'écrire la première ligne de code : mémoire, processeur, carte graphique, stockage. Les chiffres ci-dessous sont ceux que nous appliquons sur nos propres déploiements, sur DGX Spark, sur Framework Desktop et sur instances GPU OVH ou Scaleway. La machine peut vivre dans notre cloud ou dans vos locaux — le calcul est le même.

UsageMémoire modèleMachineUtilisateurs servisStockage
Modèle de décision (classification, scoring, anomalie)4 à 8 GoServeur CPU, sans GPU200 et plus20 Go
OCR documentaire (factures, contrats, formulaires)8 à 16 GoServeur CPU, GPU utile en traitement par lots50 en flux continu100 Go et plus selon l'archivage
Transcription Whisper large (STT)10 à 16 Go de VRAMFramework Desktop ou instance GPU cloud1 flux temps réel par GPU, 10 à 20 heures d'audio par nuit en lots50 Go hors conservation des fichiers audio
LLM local 7 à 8 milliards de paramètres (quantifié)6 à 10 GoFramework Desktop 128 Go10 à 20 en simultané50 Go
LLM local 30 à 32 milliards de paramètres (quantifié)20 à 28 GoFramework Desktop 128 Go ou DGX Spark20 à 50 en simultané100 Go
LLM local 70 milliards de paramètres (quantifié)40 à 50 GoDGX Spark 128 Go de mémoire unifiée50 à 100 en simultané200 Go

Règle de dimensionnement : mémoire nécessaire = poids du modèle + environ 2 Go par conversation simultanée pour le contexte. Un modèle qui occupe 40 Go et sert 20 utilisateurs en même temps demande donc 80 Go de mémoire, pas 40.

Nos technologies

Les outils et frameworks que nous maîtrisons pour ce service.

PythonTesseractHugging FaceQwenOpenCVvLLMOllamaMCPClaude API

Nos réalisations

Projet CFEF — Recherche par transcription

Intelligence artificielle

CFEF — Recherche par transcription

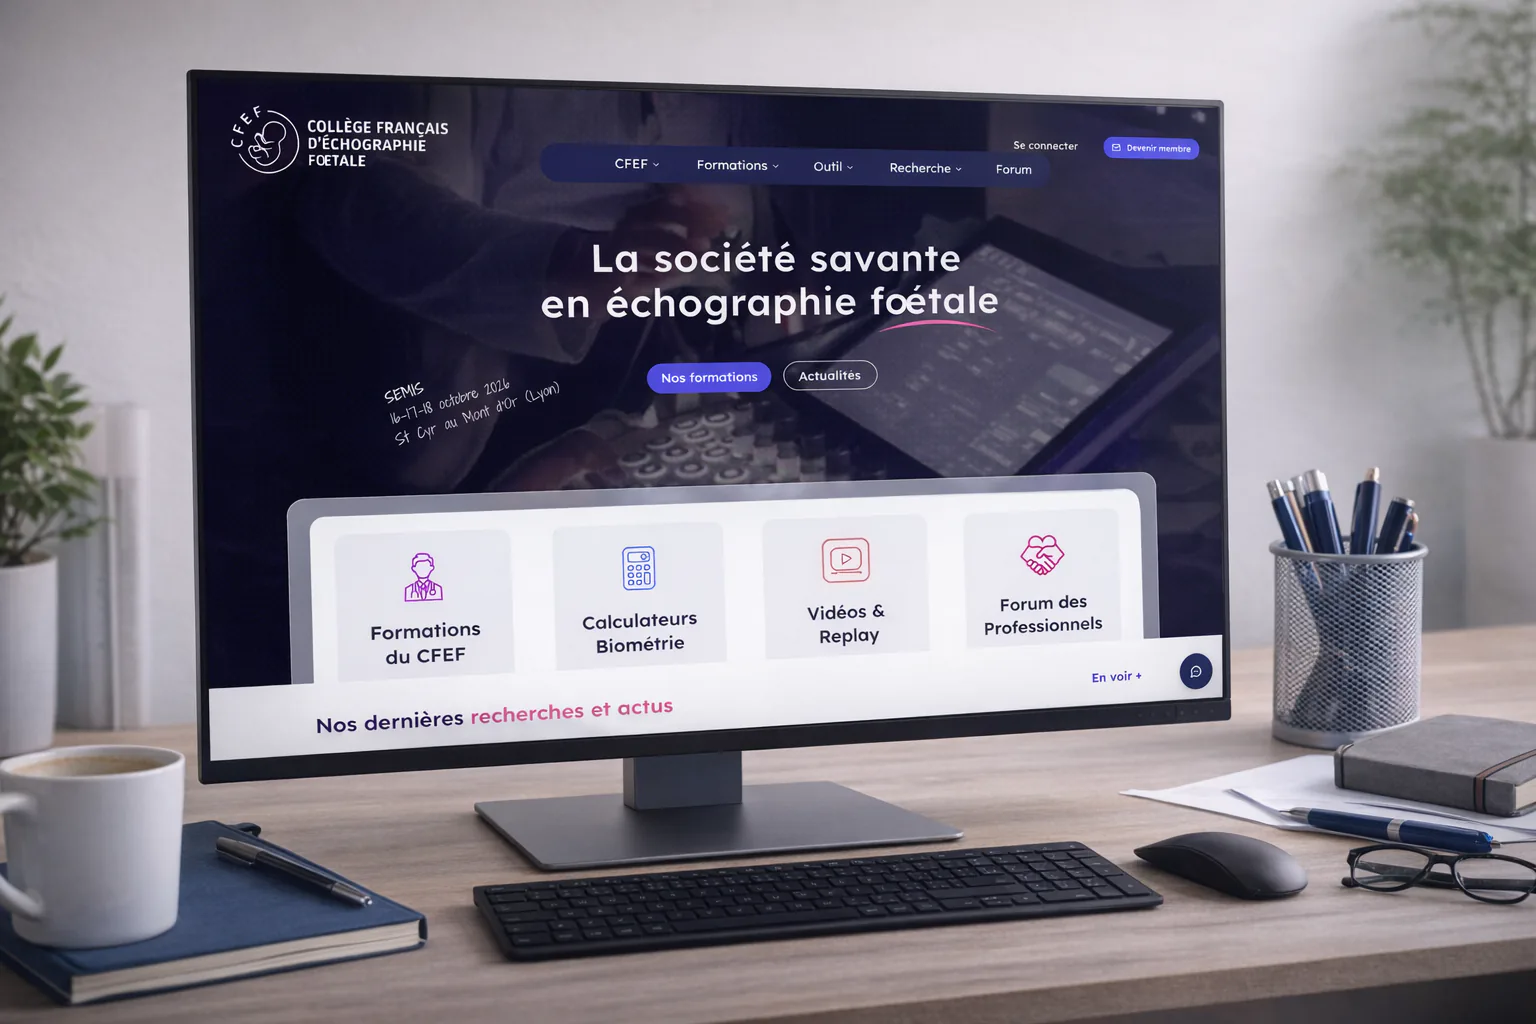
Mise en place d'un agent IA permettant la transcription automatisée (Speech-to-Text) de l'intégralité de la médiathèque du site CFEF. Cette solution transforme les flux audio en données exploitables, offrant aux utilisateurs la possibilité de filtrer et de rechercher des contenus précis par mots-clés au sein du catalogue de vidéos.

  • OpenAI
  • Whisper
  • Scripting
  • SQL
Projet Minitux — Souveraineté et infrastructure IA locale

Intelligence artificielle

Minitux — Souveraineté et infrastructure IA locale

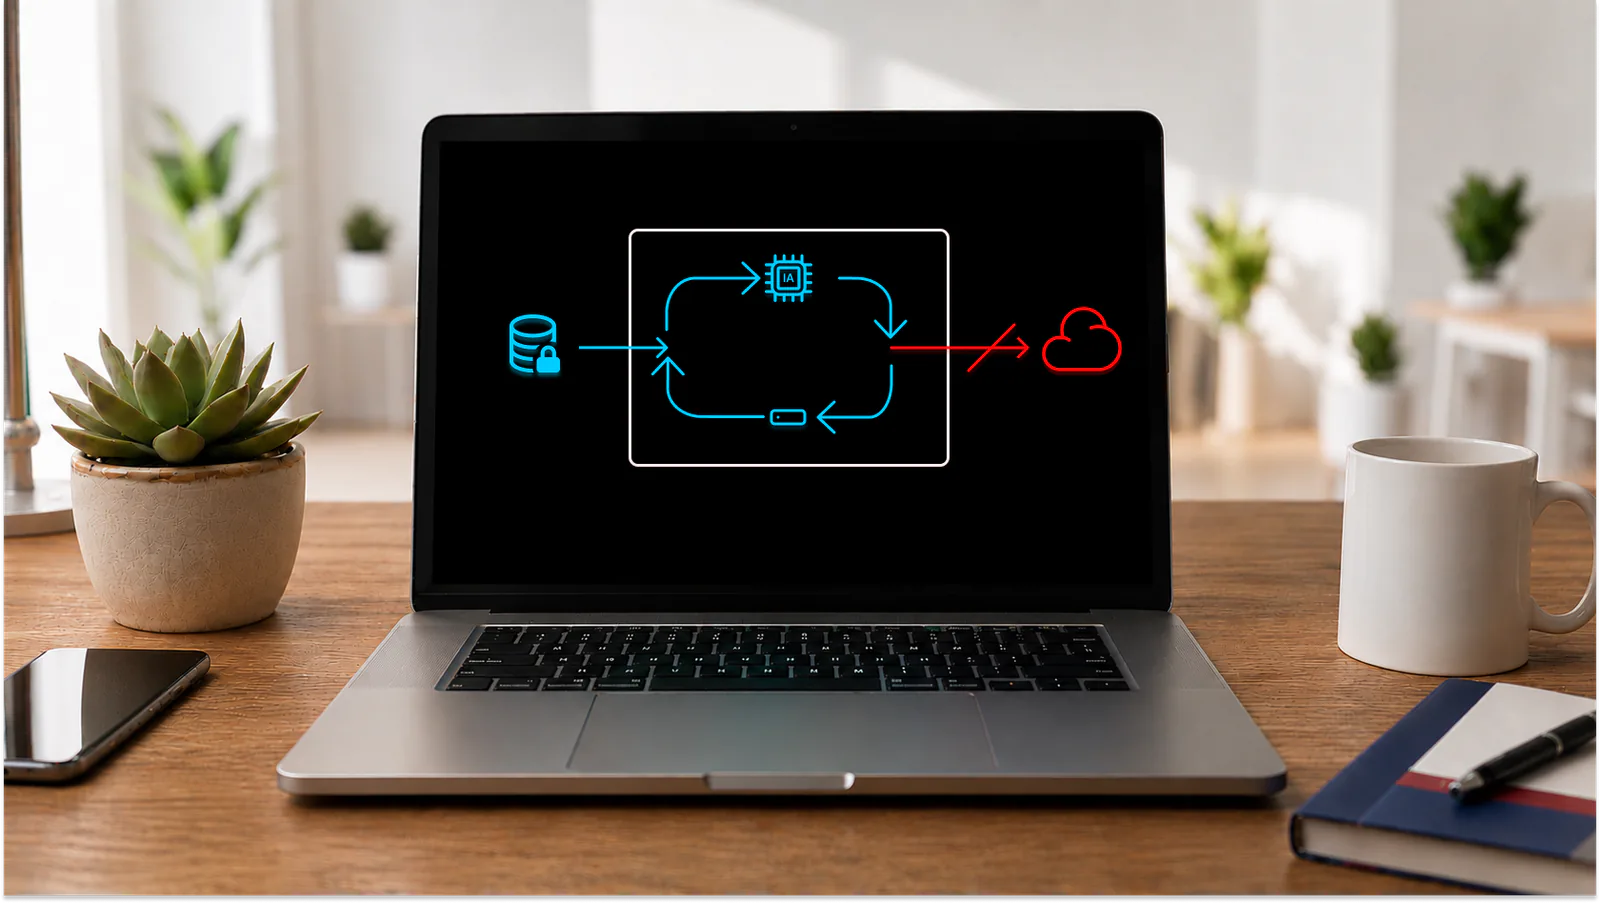
Mise en place d'une infrastructure hybride composée d'un serveur haute performance (Minitux) et de nœuds de calcul locaux pour l'exécution simultanée d'agents IA autonomes en circuit fermé.

  • Linux
  • Debian
  • Scripts bash
  • Docker

FAQ

Questions fréquentes

Quelle précision Les Entrecodeurs obtiennent-ils en extraction documentaire ?

Les Entrecodeurs dépassent 95 % de précision après calibration sur vos formats réels, et ce chiffre n'est pas le plus important. Ce qui compte est le traitement du reliquat : les documents en échec sont repris par un modèle frontier, puis par une validation humaine ciblée sur le champ incertain. Un service à 99 % qui perd silencieusement le pour cent restant vaut moins qu'un service à 95 % où chaque échec est signalé.

Faut-il envoyer nos documents sur Internet pour utiliser l'OCR ?

Non. Les Entrecodeurs déploient le service sur une machine dédiée dans vos locaux quand vos documents ne doivent pas sortir de l'entreprise — un cas fréquent en comptabilité et sur les contrats. Le service fonctionne alors avec des modèles à poids ouverts, sans appel à un service externe pour le traitement courant. L'hébergement sur nos serveurs ou sur une instance européenne reste possible quand l'élasticité prime.

Combien de documents par jour une machine peut-elle traiter ?

Un serveur CPU avec 8 à 16 Go de mémoire absorbe un flux continu correspondant à une cinquantaine d'utilisateurs, sans carte graphique. Pour une reprise d'archives ou un pic de fin de mois, Les Entrecodeurs ajoutent une carte graphique qui divise nettement le temps de traitement. Le dimensionnement précis se fait sur votre volume réel et votre délai attendu, avant le développement.

L'OCR fonctionne-t-il sur des documents manuscrits ?

Partiellement, et Les Entrecodeurs le disent avant de commencer. Les champs manuscrits courts et cadrés — une case cochée, un montant, une date dans un formulaire structuré — se lisent correctement. Un texte manuscrit libre reste peu fiable et part en validation humaine. Nous mesurons ce taux sur un échantillon de vos documents avant de vous engager sur un périmètre.

Le service OCR des Entrecodeurs est-il disponible en API ?

Une offre packagée avec API et tarification à l'usage est en préparation chez Les Entrecodeurs. Aujourd'hui, le service est déployé projet par projet : nous analysons vos documents, calibrons le modèle sur vos formats et installons le service sur nos serveurs ou sur une machine dédiée chez vous. Contactez-nous pour être informé de l'ouverture de l'offre packagée.

Que coûte l'extraction par rapport à une saisie manuelle ?

Les Entrecodeurs comparent toujours les deux sur votre volume réel. L'extraction automatique change la nature du coût : la saisie manuelle croît proportionnellement au nombre de documents, alors qu'un service OCR local a un coût d'infrastructure fixe auquel s'ajoute seulement la reprise des cas en échec. Le point de bascule dépend de votre volume, et nous le calculons avant de vous proposer quoi que ce soit.

On en parle ?

Arrêtez de ressaisir vos documents.

Sans engagement · Réponse sous 48hVoir nos réalisations